Cách tiết kiệm token cho Claude Code, Codex với Caveman, Ponytail, RTK, Context Mode, Token Optimizer: lệnh cài, use case thật, combo theo kiểu làm việc và kết quả test độc lập để anh em không cài nhầm.
Bỏ Túi AI21 phút đọcClaude Code
Cần chuẩn bị
Claude Code đã đăng nhập (có lệnh /plugin), hoặc Codex CLI
Node.js 22.13 trở lên nếu cài Caveman bằng npx; Node.js 22.5 trở lên cho Context Mode
Python 3.9 trở lên cho Token Optimizer
Homebrew (macOS, Linux) hoặc WinGet (Windows) để cài RTK
Chạy trên: windows · macos · linux
Không cần cài gìCopy được ngayÁp dụng chiều nayClaude Code
Anh em cài 5 tool tiết kiệm token, dashboard báo đã tiết kiệm 90%. Mở hoá đơn ra: không giảm. Có bài test còn thấy chi phí tăng 7,6%.
Cài theo trend, tin con số % trên dashboard, không biết token thật sự đi đâu
Đo xem token tốn ở đâu trước
Cài đúng một tool cho chỗ đó
So tiền trên cùng một việc, tính cả lần sửa
Token đang đi đâu? Chọn tool theo chỗ tốn
Kết luận trước: 5 tool này không thay nhau được. Mỗi cái cắt một chỗ khác nhau, và phần lớn chỉ chạm tới một lát nhỏ của hoá đơn.
Token là đơn vị AI dùng để tính lượng nội dung nó đọc và viết ra. Không chỉ chữ anh em gõ: file AI mở, log lệnh nó chạy, cấu hình, mô tả công cụ… đều tính token (xem Token là gì). Trong một phiên Claude Code, token chia làm hai dòng:
Phần AI đọc vào: CLAUDE.md, skill, mô tả MCP, file, log test, trang web. Dòng này thường lớn nhất.
Phần AI viết ra: câu trả lời, code, lời giải thích. Ít hơn nhưng giá mỗi token cao hơn.
Chọn tool theo chỗ đang tốn token (kiểm ngày 19/10/2026)
Anh em thấy
Chỗ tốn
Tool
Cơ chế
Giấy phép
Chưa biết tốn ở đâu
Cả phiên
Token Optimizer
Đo, soát cấu hình, skill thừa, ngữ cảnh rác
PolyForm Noncommercial
AI trả lời dài dòng
AI viết ra
Caveman
Ép câu trả lời gọn, giữ nguyên code
Apache-2.0
Code phình, tự dựng lại thứ đã có
AI viết ra
Ponytail
Ưu tiên code sẵn có, thư viện chuẩn
MIT
Log git, test, build dài
AI đọc vào
RTK
Lọc đầu ra lệnh Bash trước khi tới AI
Apache-2.0 (rtk-oss)
Đọc nhiều tài liệu, trang web, log lớn
AI đọc vào
Context Mode
Giữ dữ liệu ngoài ngữ cảnh, chỉ lấy đoạn cần
Elastic License 2.0
Mình đọc hết README của 5 tool và các bài test độc lập (JetBrains, Quesma, Scott Logic, Adobe Research). Bài học lớn nhất: con số “giảm 90%” là tỷ lệ nén trên phần tool chạm tới, không phải mức giảm hoá đơn. Chính trang tài liệu của RTK cũng ghi: giảm 90% byte đầu ra không làm phiên làm việc rẻ đi 90%. Vì vậy thứ tự đúng là: đo → cắt một chỗ → đo lại.
Bước 1: đo trước bằng Token Optimizer
Kết luận trước: Token Optimizer cho anh em biết token đang tốn vào đâu, kể cả những chỗ RTK hay Caveman không chạm tới như CLAUDE.md quá dài, skill cài mà không dùng, MCP thừa.
Lần chạy /token-optimizer đầu tiên sẽ audit từng thành phần, tự sửa phần an toàn, gợi ý phần còn lại và bật hook chạy nền. Muốn kiểm nhanh khoảng 10 giây thì dùng /token-optimizer quick.
Codex: chạy codex plugin marketplace add alexgreensh/token-optimizer, rồi gõ /plugins trong Codex để cài.
↳ Nhớ bật auto-update. Marketplace bên thứ ba mặc định tắt.
Đọc kết quả: 5 việc Token Optimizer làm được
Theo tài liệu CLI chính thức:
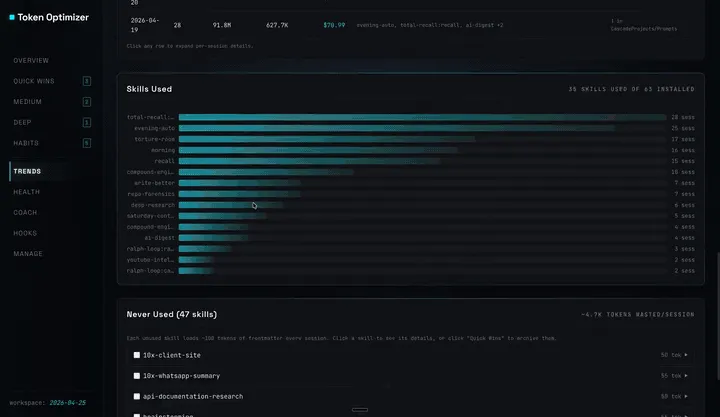
Dashboard chi phí theo từng lượt: xem lượt nào đốt nhiều nhất, theo 4 mức giá.
Fleet Auditor (/fleet-auditor): soát lãng phí trên nhiều agent, như phiên bỏ dở, vòng lặp, mô tả skill và tool chiếm trên 20% ngữ cảnh, file nhớ trên 5.000 token. Mỗi phát hiện kèm ước tính tiền mỗi tháng.
Smart compaction: lưu checkpoint trước khi Claude Code tự nén cuộc trò chuyện và khôi phục sau đó, để AI không quên file đang sửa.
route: đưa mô tả việc vào, nó gợi ý model và mức effort hợp lý. Ví dụ việc “sửa lỗi chính tả trong README” được gợi ý model nhỏ, effort thấp. Nó chỉ gợi ý, không tự đổi model.
/token-coach: nhận xét thói quen dùng token trong 30 ngày.
Nguồn: ảnh demo dashboard trong README của alexgreensh/token-optimizer, dữ liệu của tác giả. Chụp ngày 19/10/2026.
Hai lưu ý từ docs: phiên Claude Code trên web (claude.ai/code) bắt đầu với dữ liệu trống, nên lịch sử dashboard chỉ có phiên đó. Tính năng Keep-Warm (giữ cache nóng) mặc định tắt và không chạy khi anh em dùng gói trả theo tháng.
↳ Mọi số liệu trong dashboard được gắn nhãn Measured, Estimated hoặc Opportunity. Chỉ tin nhãn Measured.
Giấy phép PolyForm Noncommercial: miễn phí cho cá nhân, nghiên cứu. Theo README, nhóm dưới 5 người và doanh thu dưới 20.000 USD/tháng có thể xin giấy phép miễn phí; công ty lớn hơn phải liên hệ tác giả.
Bớt phần AI viết ra: Caveman và Ponytail
Kết luận trước: Caveman cắt lời, Ponytail cắt code. Hai cái hay được ghép cặp, nhưng chưa có bài test nào đo khi dùng chung.
Caveman: AI nói ít lại, code giữ nguyên
Ai từng hỏi “sao component re-render” mà nhận lại ba đoạn văn sẽ hiểu Caveman sinh ra để làm gì. README đưa ví dụ: câu trả lời 63 token còn 20 token, cùng một cách sửa.
Chỉ cần câu trả lời gọn thì cài bản skill:
$ npx skills add JuliusBrussee/caveman -g
Bản đầy đủ Caveman 4 có sáu phần (trả lời gọn, nén log đọc vào, tự chọn model, duyệt web nén…). Cài bằng npx @caveman-ai/cli@latest (Node.js 22.13+), hoặc trong Claude Code:
Hỏi đáp nhanh khi debug: bật /caveman, cần gọn hơn nữa thì /ultracave. Tắt bằng /caveman off hoặc gõ stop caveman.
Review code một dòng một lỗi:/caveman-review trả về kiểu L42: null deref. Guard it.
Thu gọn CLAUDE.md, file nhớ:/caveman-compress <file>. Nó giữ bản sao lưu, nhưng nội dung file được gửi lên nhà cung cấp model để nén.
Cắt lời dẫn của subagent: phân tích 455 phiên của Kunal Ganglani cho thấy subagent tạo ra 64% phần viết ra. Lời gợi ý của anh ấy: bật Caveman cho phần máy nói với máy, giữ commit message, mô tả PR, giải thích review viết đủ ý để người sau còn hiểu vì sao.
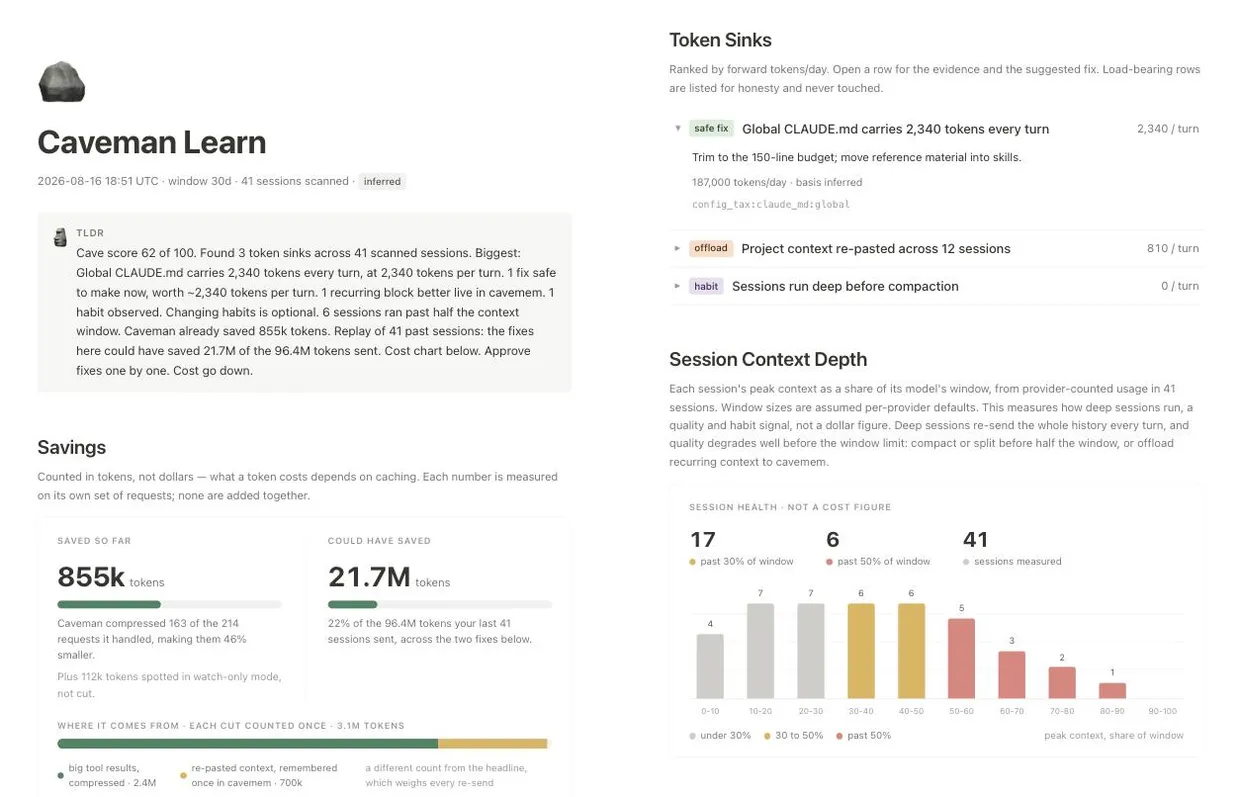
Tìm chỗ tốn (bản đầy đủ):caveman learn quét các phiên cũ, xếp hạng “token sink” như CLAUDE.md quá dài hay ngữ cảnh dán lại nhiều lần, rồi đề xuất từng cách sửa để anh em duyệt.
Phiên bản theo ngành: Elastic làm elastic-caveman cho việc truy vấn Elasticsearch qua MCP; họ đo 8 tình huống, token phản hồi giảm 63,6%.
Nguồn: ảnh báo cáo mẫu trong README của JuliusBrussee/caveman (Apache-2.0). Chụp ngày 19/10/2026.
Gotcha:
Viết prompt bình thường, chỉ nén câu trả lời. Nghiên cứu CAVEWOMAN của Adobe Research cho thấy nén câu trả lời giảm chi phí 1,4 đến 2,4 lần tuỳ model; còn viết prompt kiểu caveman thì chi phí lại tăng và độ chính xác giảm mạnh.
Bộ luật của skill tốn khoảng 1.160 token đầu vào mỗi lần (theo README). Với câu hỏi ngắn hoặc gói tính tiền theo lượt request, phần này có thể ăn hết phần tiết kiệm.
Bản CLI mặc định gửi thống kê sử dụng; tắt bằng caveman telemetry off.
Ponytail: “ông senior lười” bên trong agent
Ponytail giả lập một senior lâu năm: nhìn 50 dòng code của bạn, xoá còn 1 dòng. Trước khi viết code mới, nó đi theo thang: việc này có cần không → codebase đã có chưa → thư viện chuẩn hoặc tính năng trình duyệt có không → dependency đã cài có không → cuối cùng mới viết phần tối thiểu.
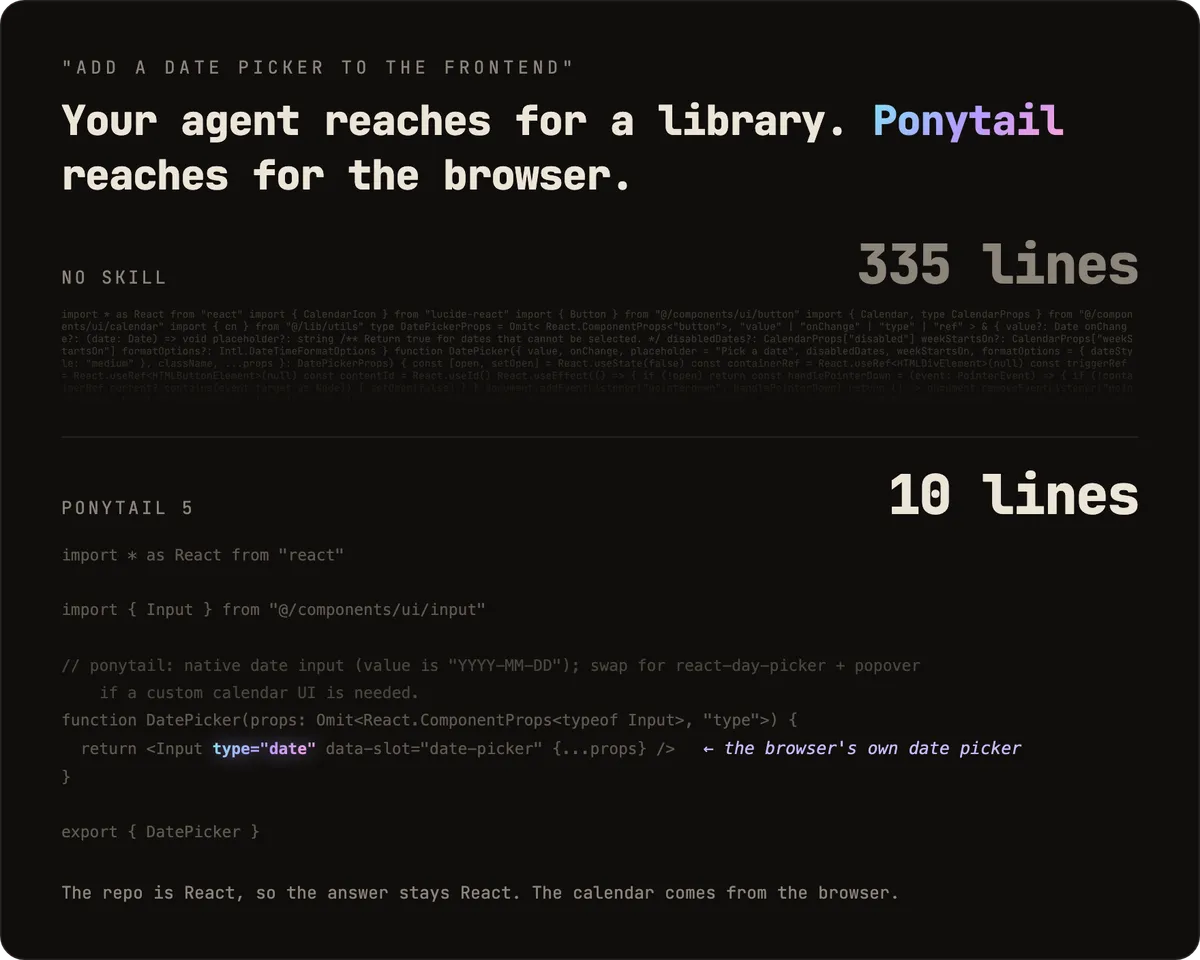
Ví dụ trong README: nhờ thêm ô chọn ngày, agent không có skill dựng cả bộ lịch 335 dòng; có Ponytail, nó dùng component Input sẵn có với type="date", 10 dòng, trình duyệt tự hiện lịch.
Nguồn: README của DietrichGebert/ponytail (MIT), số liệu do tác giả đo. Chụp ngày 19/10/2026.
Rồi mở /hooks trong Codex, trust hai hook của Ponytail và mở thread mới. Agent khác (Cursor, Copilot, Gemini…): chép file AGENTS.md của repo vào dự án.
Use case:
Làm ticket tính năng: để mặc định, Ponytail chặn thói quen cài thêm thư viện cho việc nhỏ.
Chọn mức theo việc:/ponytail full cho tính năng lớn, /ponytail lite cho sửa nhỏ, /ponytail off cho phần nhạy cảm như xác thực, thanh toán.
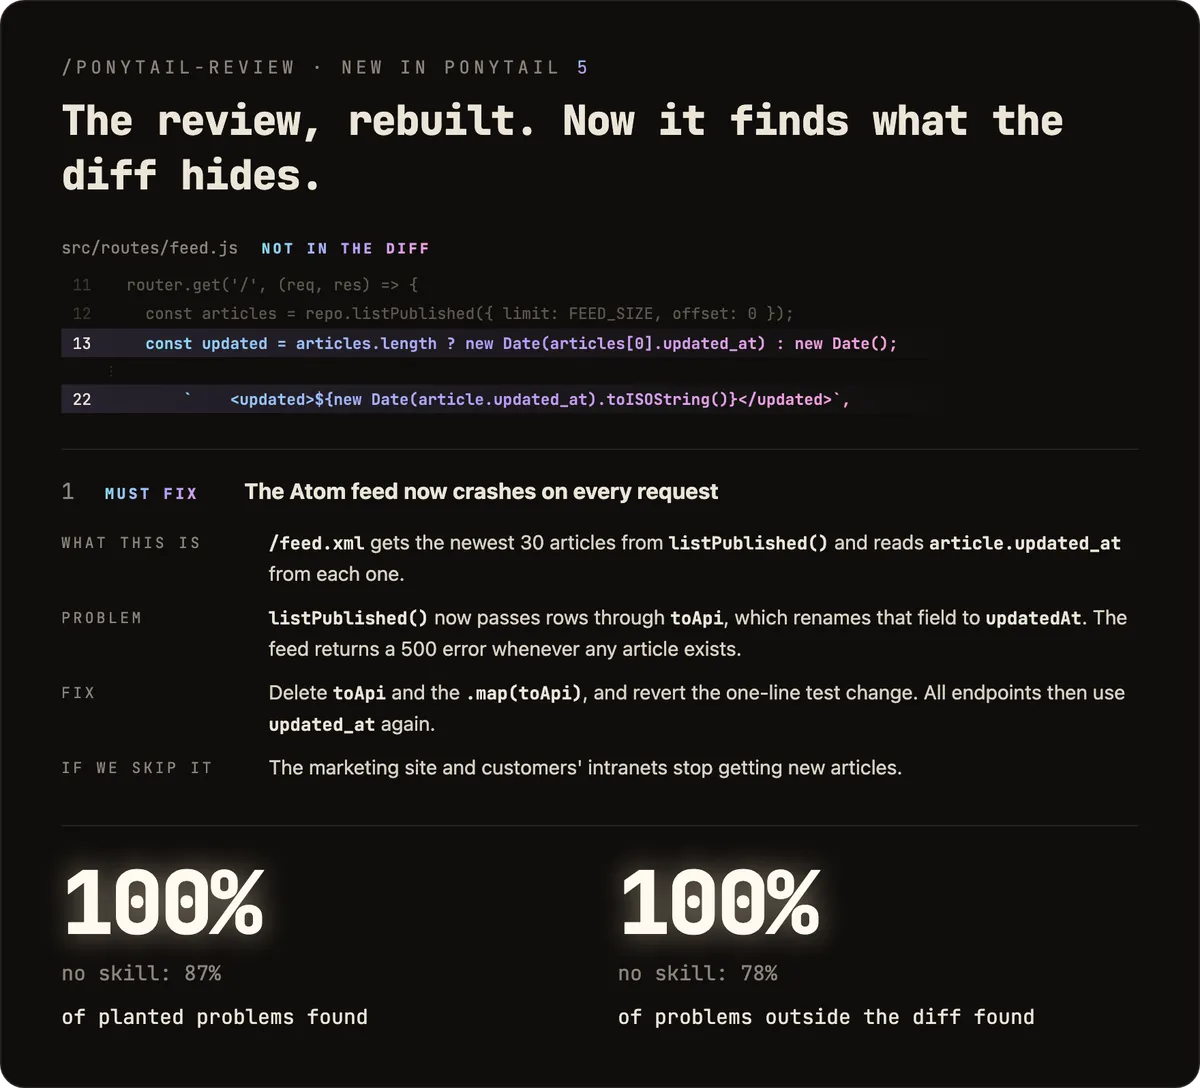
Review trước khi merge:/ponytail-review staged, hoặc dán link PR. Bản mới đọc cả code xung quanh diff, kiểm lỗi, bảo mật, test thiếu và phần thừa.
Dọn cả repo:/ponytail-audit xếp hạng việc cần sửa trước.
Theo dõi “nợ” cố ý:/ponytail-debt gom các comment shortcut: thành danh sách để quay lại xử lý.
Nguồn: README của DietrichGebert/ponytail (MIT). Tỷ lệ 100% trong ảnh là benchmark của tác giả. Chụp ngày 19/10/2026.
Gotcha: JetBrains thấy bản skill “trơn” (không có hook) bị agent bỏ qua ở cả 10 phiên thử, nên hãy cài plugin có hook. Sau khi đổi mức, gõ /ponytail để chắc mức mới đã nhận (repo có issue báo đổi mức không ăn trên Claude Code).
CLAUDE.md — quy ước gọn mà không mất ý
Cách trả lời và viết code
- Trả lời thẳng kết quả, không chào, không tóm tắt lại điều mình vừa hỏi.
- Trước khi viết code mới: tìm trong repo và thư viện chuẩn xem đã có thứ dùng lại được chưa.
- Không bỏ validation, xử lý lỗi, kiểm tra bảo mật để code ngắn hơn.
- Commit message và mô tả PR: viết đủ lý do thay đổi, không viết kiểu rút gọn.
- Việc của phần nhạy cảm, ví dụ: thanh toán, xác thực: giải thích đầy đủ trước khi sửa.
Bớt phần AI đọc vào: RTK và Context Mode
Kết luận trước: đây là hai tool nén mạnh nhất trên giấy, nhưng cũng là chỗ dễ hiểu nhầm nhất. Chúng chỉ chạm tới một phần những gì AI đọc.
RTK: lọc log lệnh trước khi tới AI
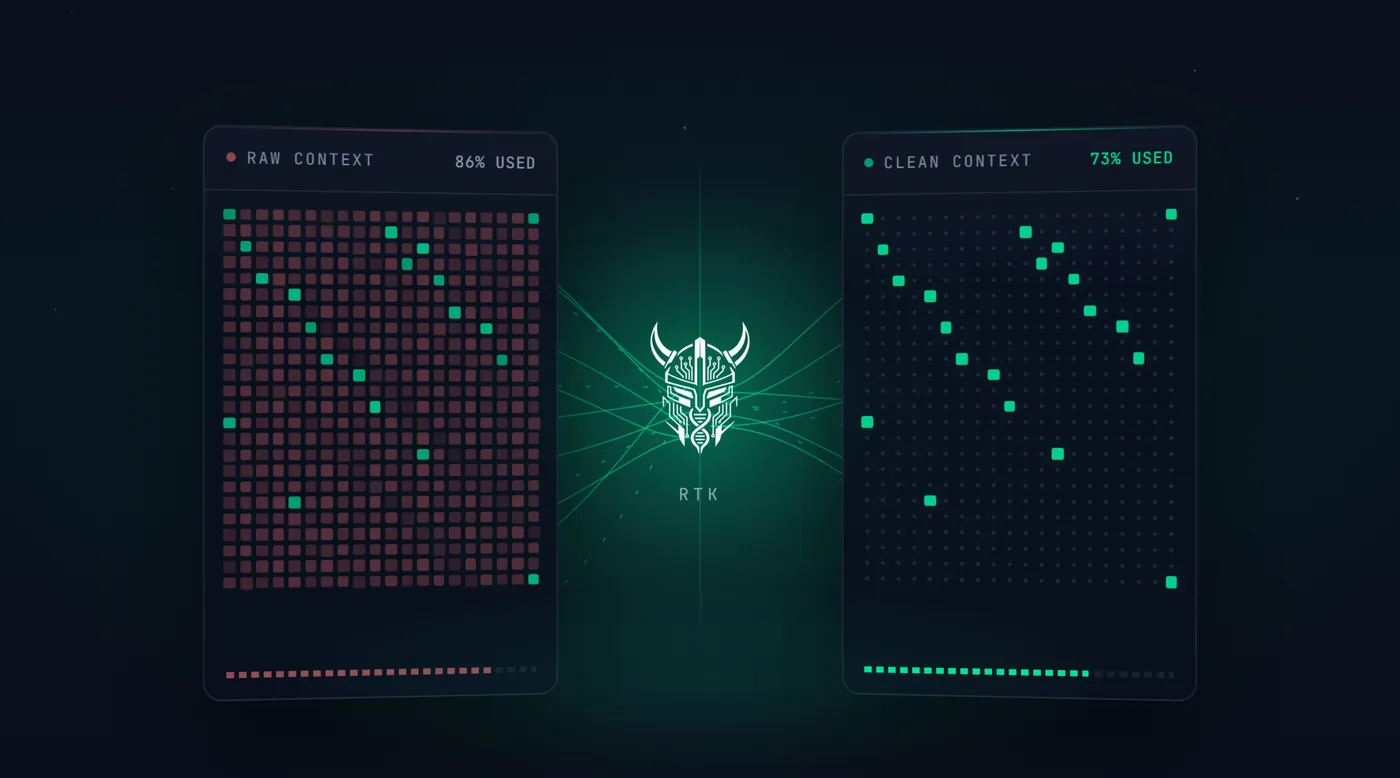
RTK đứng giữa agent và terminal. Agent chạy git status hay cargo test, RTK tự đổi thành rtk git status, lọc bỏ phần thừa rồi mới trả kết quả. Bài ra mắt trên r/ClaudeCode lấy ví dụ cargo test từ 155 dòng còn 3 dòng.
Nguồn: trang chủ rtk-ai.app, khung hình từ hình động minh hoạ của hãng, phần trăm trong ảnh không phải số đo. Chụp ngày 18/10/2026.
$ brew install rtk # macOS / Linux
$ winget install rtk-ai.rtk # Windows
$ rtk --version
$ rtk gain
rtk gain phải hiện bảng thống kê. Báo lỗi là anh em cài nhầm một gói khác cũng tên rtk trên crates.io.
Gắn vào agent rồi khởi động lại:
$ rtk init -g # Claude Code
$ rtk init -g --codex # Codex
$ rtk init --show # hook phải hiện [ok]
Use case và lệnh hay dùng:
Xem tiết kiệm theo ngày:rtk gain --daily, rtk gain --graph.
Tìm lệnh chưa đi qua RTK:rtk discover --all --since 7 liệt kê lệnh trong 7 ngày chạy mà không được lọc.
Cần log gốc để debug:rtk bypass <lệnh> chạy một lệnh không lọc, hoặc đặt RTK_DISABLED=1 trước lệnh. Muốn loại hẳn lệnh nào (ví dụ git push, Playwright) thì thêm vào exclude_commands trong file cấu hình.
Lấy lại đoạn bị cắt: RTK in ra mã gợi ý, agent chạy rtk recall <mã> để xem bản đầy đủ.
Gotcha quan trọng:
Hook chỉ bắt lệnh Bash. Công cụ Read, Grep, Glob có sẵn của Claude Code không đi qua RTK. Khi JetBrains phát lại 83 phiên thật, 34% ký tự đầu ra công cụ đến từ ba công cụ này.
Chọn bản rtk-oss (Apache-2.0) nếu chỉ cần lọc lệnh. Bản rtk đầy đủ có phần lõi BUSL-1.1, hai bản không cài chung được.
Windows: bản trước v0.37.2 không đăng ký hook trên Windows gốc; cập nhật rồi chạy lại rtk init -g.
Telemetry tắt mặc định.
Context Mode: dữ liệu lớn để ngoài, chỉ lấy đoạn cần
Context Mode là một MCP server (cách gắn thêm công cụ cho agent, xem MCP là gì). Kết quả lớn như ảnh chụp trang web của Playwright, file log, JSON từ API được giữ trong hộp cát và đánh chỉ mục; AI tìm đoạn liên quan thay vì nhận cả khối.
Khởi động lại (hoặc /reload-plugins), kiểm bằng /context-mode:ctx-doctor (mọi dòng phải có [x]). Codex cần thêm bước bật hook trong cấu hình, xem mục Codex CLI trong README Context Mode.
Use case:
Đọc tài liệu, trang web dài: AI dùng ctx_fetch_and_index để lưu trang vào chỉ mục, rồi ctx_search lấy đúng đoạn cần. Tự làm tay: /context-mode:ctx-index và /context-mode:ctx-search.
Debug với Playwright, log truy cập, JSON lớn: README đưa ví dụ ảnh chụp trang Playwright 56,2 KB còn 299 byte trong ngữ cảnh.
“Nghĩ bằng code”: thay vì đọc 50 file để đếm hàm, AI viết script đếm rồi chỉ in kết quả.
Làm tiếp sau khi cuộc trò chuyện bị nén: Context Mode ghi file đã sửa, lỗi, quyết định vào SQLite rồi khôi phục khi cần. Không dùng --continue thì dữ liệu phiên trước bị xoá ngay.
Xem đã giúp được bao nhiêu:/context-mode:ctx-stats. Xoá chỉ mục: /context-mode:ctx-purge.
Gotcha và phản biện:
Context Mode không chặn được phản hồi của MCP server khác, theo một người thử trên Hacker News.
Trong thảo luận HN, có người thấy hook “quá gắt”: AI phải viết đúng script trích dữ liệu ngay lần đầu, nếu không sẽ thiếu thông tin. Tác giả xác nhận chưa chạy bài đo chất lượng câu trả lời.
ctx_execute chạy code với quyền truy cập file của tiến trình, không phải hộp cát hệ điều hành đầy đủ. Đặt CTX_FETCH_STRICT=1 để chặn truy cập mạng nội bộ.
Context Mode không ép AI trả lời ngắn. Muốn gọn thì ghép Caveman.
Combo theo kiểu làm việc và kết quả test thật
Kết luận trước: chọn một tool theo kiểu việc của anh em, đo lại sau một tuần, rồi mới thêm tool thứ hai.
Gợi ý combo theo kiểu làm việc
Anh em là
Bắt đầu với
Thêm sau
Lý do
Mới dùng Claude Code, chưa biết tốn ở đâu
Token Optimizer
Tuỳ kết quả audit
Biết chỗ tốn rồi mới chọn
Làm frontend, hay thêm tính năng
Ponytail
Caveman
Code phình là chỗ tốn chính
Chạy test, build liên tục
RTK (rtk-oss)
Token Optimizer
Log lệnh dài, lặp lại nhiều lần
Nghiên cứu tài liệu, scrape web, debug Playwright
Context Mode
Caveman
Dữ liệu đọc vào rất lớn
Trưởng nhóm, nhiều người dùng chung
Token Optimizer (Fleet Auditor)
Ponytail
Cần thấy cả nhóm tốn ở đâu
Bảng dưới gom các con số đáng chú ý. Hãng tự đo thường đẹp hơn bên thứ ba đo; đọc cột cuối trước khi tin.
Hãng tự đo và bên thứ ba đo (kiểm ngày 19/10/2026)
Tool
Hãng tự đo
Bên thứ ba đo
Đọc thế nào
Caveman
Đọc vào giảm 33,2% trên 54 phiên Claude Code
JetBrains: phần viết ra giảm 8,5%, chất lượng không khác biệt (p = 0,82)
Lời gọn hơn thật, nhưng lời chỉ là phần nhỏ của phiên agent
Ponytail
Chi phí giảm 26%, code giảm 53% trên 39 việc
JetBrains: chi phí giảm khoảng 10,3%, code giảm khoảng 15% trên 80 cặp việc
Có tác dụng, khoảng một phần tư đến một nửa mức hãng công bố
RTK
Đầu ra lệnh nhỏ hơn 60–90%
JetBrains: chi phí mỗi việc tăng 7,6% ở effort thấp, gần như không đổi ở effort cao; Quesma: −5% hoặc +5% tuỳ model
Nén log không đồng nghĩa hoá đơn giảm
Context Mode
315 KB còn 5,4 KB trên 14 tình huống
-
Chưa có bài đo chất lượng câu trả lời
Token Optimizer
Chi phí giảm 14,3% trên Terminal-Bench 2
-
Số liệu mới từ phía tác giả
Vì sao RTK nén mạnh mà chi phí không giảm? Theo bản tóm tắt của Magica, trong bài test JetBrains agent cần thêm lượt và đọc thêm cache để bù phần thông tin bị lọc. Ngoài ra rtk gain lấy đầu ra thô làm mốc, kể cả phần Claude Code vốn đã tự cắt, nên con số trên dashboard luôn đẹp hơn hoá đơn.
Tự đo trong 4 bước
Chọn một việc lặp lại được, ví dụ “sửa lỗi X và chạy test tới khi qua”.
Làm một lần không bật tool: ghi token hoặc chi phí, số lần anh em phải nhắc sửa.
Bật một tool, làm lại đúng việc đó trên cùng model và mức effort.
Hai lần phải đạt yêu cầu như nhau mới so tiền.
so-sanh-truoc-sau.txt
Mình vừa làm việc “mô tả việc” hai lần: lần 1 không có tên tool, lần 2 có. Số liệu: token hoặc chi phí, số lượt, số lần phải sửa của mỗi lần. So sánh giúp mình: kết quả hai lần có đạt yêu cầu như nhau không, chi phí chênh bao nhiêu, phần chênh đến từ đâu. Nếu thiếu số liệu để kết luận thì nói rõ cần đo thêm gì.
Lỗi hay gặp khi cài tool tiết kiệm token
Kết luận trước: phần lớn rắc rối đến từ việc cài chồng nhiều tool làm cùng một việc, và tin số trên dashboard.
Cài chồng chức năng. Bộ Caveman đầy đủ có phần nén log, Token Optimizer cũng nén đầu ra lệnh, RTK cũng vậy. Bật cả ba thì không biết cái nào có tác dụng, lại dễ cắt mất thông tin AI cần.
Dashboard báo tiết kiệm lớn, hoá đơn không đổi. Đúng như các bài test ở trên. Hãy nhìn trang usage hoặc billing của nhà cung cấp.
AI sửa sai vì thiếu log. Dùng rtk bypass, rtk recall, hoặc tắt Caveman cho việc cần giải thích kỹ.
Cài xong không thấy khác. RTK chỉ bắt lệnh Bash; Ponytail bản skill trơn hay bị bỏ qua; Context Mode cần hook bật đủ (ctx-doctor).
Quên giấy phép. Token Optimizer (PolyForm Noncommercial) và Context Mode (Elastic License 2.0) có điều kiện khi dùng thương mại hoặc làm dịch vụ.
Dùng trên claude.ai/code. Phiên cloud không đọc plugin cài trên máy. Bật plugin trong tài khoản (ứng dụng Desktop → Customize) hoặc khai báo trong .claude/settings.json của repo.
0/5
túi còn trống
Tool tiết kiệm token nào nên cài đầu tiên?
Token Optimizer, vì nó cho anh em biết token đang tốn ở đâu. Sau đó mới chọn Caveman, Ponytail, RTK hoặc Context Mode theo đúng chỗ tốn nhất.
Cài cả 5 tool cùng lúc được không?
Được, nhưng khó biết tool nào có tác dụng và dễ trùng chức năng: bộ Caveman đầy đủ, Token Optimizer và RTK đều có phần nén đầu ra lệnh. Nên cài từng cái, đo trước và sau.
RTK báo tiết kiệm 90% sao hoá đơn không giảm?
Con số của rtk gain là tỷ lệ nén trên đầu ra lệnh Bash, không phải cả phiên. Bài test của JetBrains thấy chi phí mỗi việc tăng 7,6% ở effort thấp vì agent cần thêm lượt, và gần như không đổi ở effort cao.
Caveman có làm AI trả lời kém đi không?
Bài test của JetBrains trên 86 việc lập trình không thấy khác biệt chất lượng đo được. Adobe Research cảnh báo: chỉ nén câu trả lời, đừng viết prompt kiểu caveman vì độ chính xác giảm mạnh.
Các tool này có tăng hạn mức Claude.ai hay ChatGPT trên web không?
Không. Chúng gắn vào agent lập trình như Claude Code và Codex, giảm token agent đọc và viết trong phiên. Chúng không thay đổi hạn mức gói của anh em.
Dùng Codex thì cài được những tool nào?
Cả 5 đều có hướng dẫn cho Codex: Caveman qua npx skills, Ponytail và Token Optimizer qua codex plugin marketplace, RTK bằng rtk init -g --codex, Context Mode theo mục Codex CLI trong README.
 Bỏ Túi AI