 Bỏ Túi AI
Bạn gõ 10 chữ. AI lại bảo câu đó là 16 token. Nó đếm kiểu gì vậy?
10 chữ = 10 chữ, đúng không?
- Tiếng Việt: 16 token
- Tiếng Anh cùng nghĩa: 10 token
- Cùng một câu, hai cách cắt khác nhau
Token như những viên Lego
Kết luận trước: AI không đọc theo chữ như mình. Nó cắt văn bản thành các viên Lego có sẵn trong “hộp đồ chơi” của nó, gọi là bộ từ vựng của tokenizer.
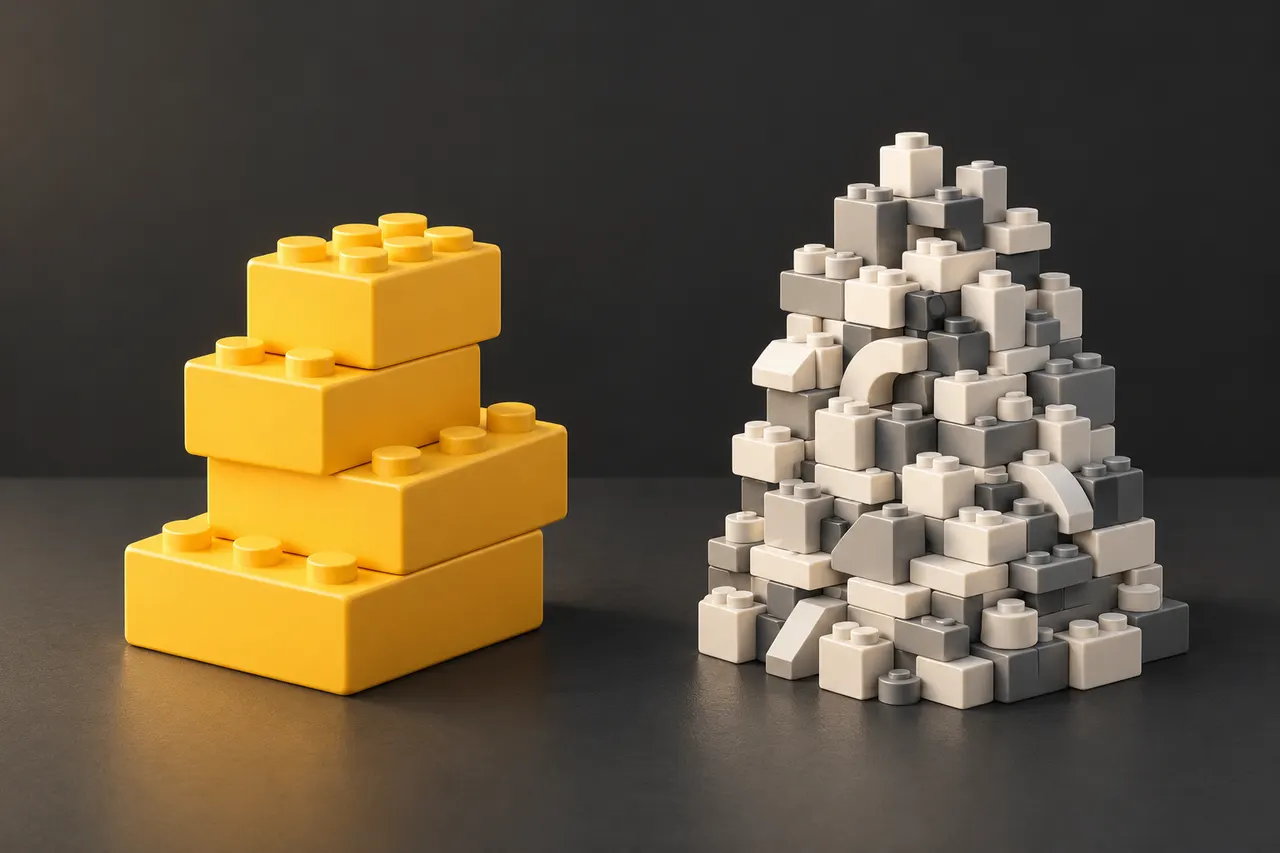
Tokenizer là phần cắt chữ. Khi được tạo ra, nó học từ rất nhiều văn bản, phần lớn là tiếng Anh. Chuỗi nào gặp nhiều thì được làm sẵn thành một viên lớn. Chuỗi nào ít gặp thì phải ghép từ nhiều viên nhỏ.
- Từ tiếng Anh phổ biến như
meetingthường là một viên nguyên khối. - Chữ tiếng Việt có dấu như
biên bảndễ bị cắt thành nhiều mẩu hơn, vì các tổ hợp chữ và dấu thanh ít xuất hiện trong dữ liệu gốc.
Với văn bản tiếng Anh, OpenAI ước lượng 1 token ≈ 4 ký tự ≈ 3/4 từ, tức 100 token ≈ 75 từ. Đây chỉ là con số trung bình cho tiếng Anh. Ngôn ngữ khác có tỷ lệ khác.
Thử ngay: gõ một câu và xem token
Gõ hoặc dán bất kỳ câu nào vào ô dưới. Mỗi màu là một token. Dấu · là dấu cách, vì dấu cách cũng là một phần của token.
Đếm bằng tokenizer mã nguồn mở của OpenAI, chạy ngay trên trình duyệt của bạn, không gửi chữ đi đâu. Claude và Gemini dùng tokenizer riêng nên con số sẽ khác.
Bạn sẽ thấy hai con số khác nhau, vì hai tokenizer cắt khác nhau:
- o200k_base là tokenizer mới của OpenAI, dùng từ GPT-4o trở đi. Bộ từ vựng của nó lớn hơn và có nhiều “viên” tiếng Việt hơn.
- cl100k_base là tokenizer cũ của GPT-3.5 và GPT-4.
Claude và Gemini dùng tokenizer riêng, nên con số sẽ không giống hệt. Dù vậy, cách cắt vẫn theo cùng một nguyên lý.
Context window: “mặt bàn làm việc” của AI
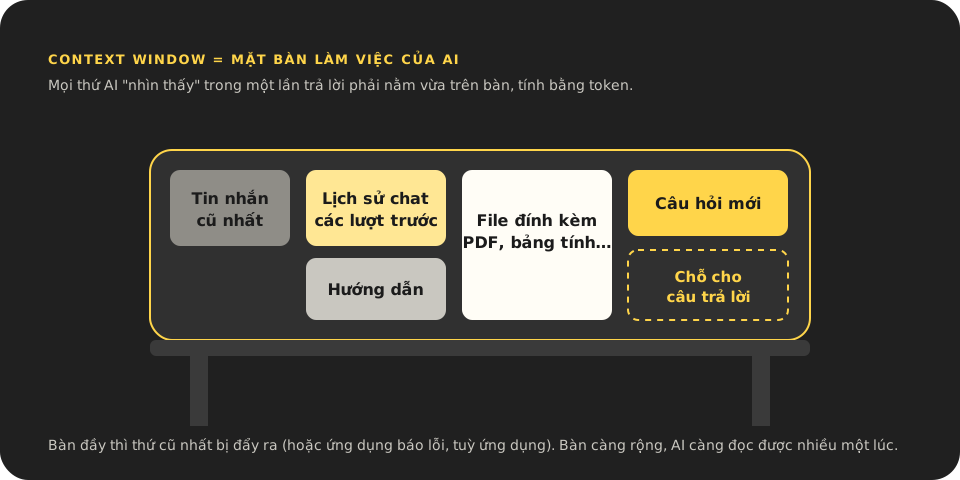
Context window là số token tối đa AI nhìn thấy cùng lúc trong một lần trả lời. Hãy hình dung nó là mặt bàn. Trên bàn phải vừa đủ:
- hướng dẫn của ứng dụng;
- lịch sử chat;
- file bạn đính kèm;
- câu hỏi mới;
- và cả chỗ trống cho câu trả lời.
Mặt bàn của các mô hình lớn hiện nay đã rất rộng:
| Hãng | Mô hình | Context window | Trả lời dài tối đa |
|---|---|---|---|
| Anthropic | Claude Opus 5.5, Sonnet 5.5, Haiku 5.5, Fable 5.1 | 1 triệu token | 128 nghìn token |
| OpenAI | GPT-6 Astra (cùng họ: GPT-6.1 Sol, GPT-6 Luna) | 1,05 triệu token | 128 nghìn token |
| Gemini 4 Argon | 1 triệu token (gộp vào và ra) | - |
Theo Anthropic, với tokenizer hiện tại của Claude, 1 triệu token chứa khoảng 555 nghìn từ tiếng Anh, hay 2,5 triệu ký tự. Nếu một trang khoảng 500 từ, con số đó tương đương hơn một nghìn trang tiếng Anh. Tiếng Việt sẽ ít trang hơn.
Lưu ý: ứng dụng chat (ChatGPT, Claude, Gemini bản dùng hằng ngày) có thể cho bạn dùng mặt bàn nhỏ hơn con số API, tuỳ gói.
Bàn đầy thì sao?
Mỗi nơi xử lý một kiểu:
- API của Claude: nếu đầu vào đã vượt giới hạn thì báo lỗi, không tự bỏ bớt.
- Ứng dụng chat: có thể tự tóm tắt hoặc gạt bớt phần đầu cuộc trò chuyện.
Vì thế, cuộc chat rất dài đôi khi khiến AI “quên” điều bạn dặn từ đầu.
Token và tiền
Kết luận trước: khi dùng qua API, bạn trả tiền theo token. Phần AI viết ra (output) đắt hơn phần bạn đưa vào (input), thường khoảng 5 lần.
| Mô hình | Đưa vào (input) | AI viết ra (output) |
|---|---|---|
| Claude Sonnet 5.5 | $2 | $10 |
| GPT-6.1 Sol (prompt dưới 272 nghìn token) | $2 | $10 |
| Gemini 3.8 Flash (giá đến 31/12/2026) | $0,75 | $3,75 |
Ví dụ tính nhanh: nhờ Claude Sonnet 5.5 tóm tắt một tài liệu dài 15.000 token, nhận về bản tóm tắt 1.000 token.
- Phần đưa vào: 15.000 × $2 / 1.000.000 = $0,03
- Phần viết ra: 1.000 × $10 / 1.000.000 = $0,01
- Tổng cộng: khoảng 4 xu Mỹ.
Nếu bạn dùng gói tháng của ChatGPT, Claude hay Gemini, bạn không trả tiền theo từng token. Dù vậy, hạn mức sử dụng của gói vẫn được tính dựa trên lượng token bạn dùng.
Vì sao tiếng Việt tốn token hơn — và mức chênh đã giảm nhiều
Kết luận trước: con số “tiếng Việt tốn gấp 4–5 lần” là chuyện của tokenizer đời cũ. Với tokenizer mới, mức chênh còn khoảng 1,3–1,9 lần.
Bỏ Túi AI đã đo bằng chính hai tokenizer trong khung thử ở trên, ngày 18/10/2026:
| Câu | Tiếng Anh | Tiếng Việt, tokenizer mới (o200k) | Tiếng Việt, tokenizer cũ (cl100k) |
|---|---|---|---|
| Nhờ tóm tắt biên bản họp | 10 | 16 (gấp 1,6 lần) | 28 (gấp 2,8 lần) |
| Thông báo cắt điện bảo trì | 24 | 31 (gấp 1,3 lần) | 49 (gấp 2 lần) |
Kết quả này khớp với các phép đo công khai khác:
- Bài đo trên Viblo: 11 tokenizer, một cặp đoạn văn. Tỷ lệ Việt/Anh là 4,03 lần với GPT-2 đời cũ, 2,14 lần với cl100k và 1,34 lần với o200k. Chỉ riêng việc chuyển từ cl100k sang o200k đã giảm khoảng 37% số token tiếng Việt.
- Nghiên cứu “The Tokenization Tax”: poster tại một workshop của NeurIPS 2026. Trên 6 mô hình mã nguồn mở cỡ 7–9 tỷ tham số, tỷ lệ dao động từ 0,83 đến 1,93 lần. Lý do chính là dấu thanh bị tách thành token riêng.
Bẫy ít ai biết: chữ có dấu “dựng sẵn” và “tổ hợp”
Cùng một chữ “ế” có thể được máy tính lưu theo hai cách:
- Dựng sẵn (NFC): gói gọn trong một ký tự.
- Tổ hợp (NFD): chữ “e” cộng với dấu mũ, cộng thêm dấu sắc.
Mắt bạn không thấy khác gì, nhưng tokenizer thì thấy.
Bỏ Túi AI thử câu thông báo ở trên: bản dựng sẵn ra 31 token, còn bản tổ hợp ra 87 token, gấp gần 3 lần. Văn bản copy từ một số file PDF hoặc phần mềm cũ có thể đang ở dạng tổ hợp. Đó là lý do cùng một câu, mỗi người đo lại ra một con số khác.
5 mẹo tiết kiệm token cho dân văn phòng
- Mở cuộc chat mới khi đổi chủ đề. Lịch sử chat cũ vẫn nằm trên bàn và tốn token ở mỗi lượt.
- Chỉ dán phần cần thiết. Cần hỏi về chương 3 thì dán chương 3, đừng dán cả tài liệu.
- Nói rõ độ dài câu trả lời, ví dụ “dưới 150 chữ” hoặc “5 gạch đầu dòng”. Phần AI viết ra là phần đắt nhất.
- Dọn văn bản trước khi dán: bỏ chữ ký email, bỏ phần trích dẫn lặp lại, bỏ bảng trống.
- Viết bằng ngôn ngữ bạn diễn đạt rõ nhất. Với tokenizer mới, mức chênh của tiếng Việt đã nhỏ. Một prompt tiếng Việt rõ ràng đáng giá hơn một prompt tiếng Anh lủng củng.
Bạn dán một bản báo cáo 40 trang rồi hỏi tiếp 30 câu trong cùng một cuộc chat. Điều gì dễ xảy ra nhất?
Mỗi lượt hỏi, toàn bộ lịch sử (cả bản báo cáo) vẫn nằm trong context window. Cuộc chat càng dài càng tốn token, và khi chạm giới hạn, phần đầu có thể bị tóm tắt hoặc gạt bớt.
1 token bằng bao nhiêu chữ?
Với tiếng Anh, OpenAI ước lượng 1 token khoảng 4 ký tự, tức 3/4 từ. Với tiếng Việt và tokenizer mới, một chữ thường tốn khoảng 1–2 token. Muốn biết chính xác, hãy dán câu vào khung thử ở trên.
1 triệu token chứa được bao nhiêu trang?
Theo Anthropic, 1 triệu token của Claude chứa khoảng 555 nghìn từ tiếng Anh, tức hơn một nghìn trang 500 từ. Tiếng Việt sẽ ít trang hơn, tuỳ tokenizer.
Tiếng Việt có thật tốn gấp 3–4 lần tiếng Anh không?
Với tokenizer đời cũ thì có thể. Với tokenizer mới như o200k của OpenAI, các phép đo công khai và phép đo của Bỏ Túi AI cho thấy mức chênh chỉ khoảng 1,3–1,9 lần.
Token ảnh hưởng giá ChatGPT, Claude, Gemini thế nào?
Qua API, bạn trả tiền theo số token đưa vào và số token AI viết ra; phần viết ra đắt hơn. Với gói tháng, bạn trả giá cố định, nhưng hạn mức sử dụng vẫn được tính dựa trên token.
Làm sao để đếm token?
Dùng khung thử ngay trong bài này cho tokenizer của OpenAI. Lập trình viên có thể dùng API đếm token miễn phí của Anthropic, hoặc thư viện tiktoken của OpenAI. Mỗi hãng đếm một kiểu, nên con số chỉ dùng để tham khảo chéo.
Hết context window thì AI quên gì?
Thường là phần đầu cuộc trò chuyện: dặn dò ban đầu hoặc file bạn gửi từ sớm. Ứng dụng chat có thể tự tóm tắt phần cũ. API của Claude thì báo lỗi nếu đầu vào vượt giới hạn.
Đọc tiếp: MCP là gì · AI Agent là gì · Prompt đầu tiên
- Anthropic — Token counting (API đếm token) — kiểm tra 18/10/2026
- Anthropic — Models overview (context window, quy đổi từ/token) — kiểm tra 18/10/2026
- Anthropic — Context windows (khi vượt giới hạn) — kiểm tra 18/10/2026
- Anthropic — Bảng giá API — kiểm tra 18/10/2026
- OpenAI — Models (GPT-6 Astra, Sol, Luna) — kiểm tra 18/10/2026
- OpenAI — Bảng giá API — kiểm tra 18/10/2026
- OpenAI — What are tokens and how to count them — kiểm tra 18/10/2026
- Google — Gemini API models — kiểm tra 18/10/2026
- Google — Gemini API pricing — kiểm tra 18/10/2026
- Viblo — Chi phí token tiếng Việt thực tế: không phải đắt gấp 4.5 lần — kiểm tra 18/10/2026
- NeurIPS 2026 workshop — The Tokenization Tax (tiếng Việt và tokenizer) — kiểm tra 18/10/2026
- gpt-tokenizer (thư viện mã nguồn mở dùng cho khung thử token) — kiểm tra 18/10/2026